Diese Schulung richtet sich an Data Scientists, Machine-Learning-Ingenieur:innen und technisch versierte Analyst:innen, die bestehende Modelle systematisch verbessern möchten.
Voraussetzungen: Solide Python-Kenntnisse, Erfahrung mit scikit-learn und ML-Grundverständnis
Schulungsinhalte
Feature Engineering und Merkmalsauswahl (manuell & automatisiert)
Skalierung, Normalisierung, Umgang mit Ausreißern
Modellauswahl und Performance-Kriterien (Precision, Recall, F1, ROC)
Hyperparameter-Tuning mit GridSearchCV, RandomizedSearchCV, Optuna
12:30–14:30 Uhr: Vertiefung, Gruppenarbeit oder Übungen
14:30–17:00 Uhr: Transfer, Diskussion & Abschluss
Dieses kompakte Tagesformat ist auf ca. 8 Zeitstunden ausgelegt und bietet eine ausgewogene Mischung aus Input, Anwendung und Reflexion – bei maximal 30 Minuten Pause.
Lernziele nach dem Lehrbaummodell
Diese Lernziele orientieren sich am Lehrbaummodell (Ellmann 2022) und fördern nachhaltiges Lernen auf kognitiver, motivationaler und metakognitiver Ebene.
Stamm: Planung & Motivation:
Die Teilnehmenden formulieren konkrete Optimierungsziele für bestehende ML-Modelle, reflektieren typische Herausforderungen wie Overfitting oder geringe Modellgüte und entwickeln Motivation zur Qualitätsverbesserung.
Kommunikation:
Die Lernenden diskutieren Tuning-Strategien, Metriken und Feature-Auswahl im Team, begründen Entscheidungen bei der Modellkonfiguration und dokumentieren ihre Erkenntnisse adressatengerecht.
Material & Struktur:
Die Teilnehmenden arbeiten mit Jupyter-Notebooks, Metrik-Reports, Visualisierungen (ROC, Precision-Recall), Feature-Engineering-Skripten und Benchmark-Vorlagen.
Gedächtnis & Aufmerksamkeit:
Zentrale Konzepte wie GridSearchCV, Cross-Validation, Feature-Skalierung oder MLOps werden durch anschauliche Beispiele, Tools wie Optuna und praxisorientierte Übungen verankert.
Aktivierung & Lernstörung:
Die Teilnehmenden experimentieren mit Hyperparametern, vergleichen Modellvarianten, analysieren unerwartete Metriken und entwickeln eine kritische Haltung gegenüber automatisierter Optimierung.
Gipfel: Überprüfung & Transfer:
Die Lernenden bewerten ihre Modellverbesserungen mit geeigneten Kennzahlen, erstellen reproduzierbare Pipelines und reflektieren die Einsatzmöglichkeiten in produktiven ML-Umgebungen.
Kursbezogene Ziele
Systematische Optimierung bestehender ML-Modelle
Methodisches Verständnis von Hyperparameter-Tuning
Transfer in produktive ML-Umgebungen mit Monitoring & Wiederverwendbarkeit
Quelle des Lehrbaummodells zur Gestaltung effektiver Lehre in der IT vom Inhaber:
M. Ellmann (2022). Effektives Lehren und Lernen in der Informatik, Wirtschaftsinformatik und verwandten Fachgebieten. Veröffentlicht in: Informatik Spektrum, Springer Nature. SPRINGER NATURE Link:
https://doi.org/10.1007/s00287-022-01436-5
Bin ich bereit für die Schulung zur Optimierung von ML-Algorithmen?
Diese kurze Selbstreflexion hilft Ihnen, Ihren Kenntnisstand besser einzuschätzen:
</> Wenn Sie 3 oder mehr Kästchen ankreuzen, ist diese Schulung ideal für Ihre Weiterentwicklung im Machine Learning.
Datenschutzhinweis: Ihre Eingaben in dieser Checkliste werden nicht gespeichert und nicht an den Server übertragen.
Passende Fachliteratur
Diese Fachbücher ergänzen die Schulung und eignen sich zur Vertiefung,
Begleitung und Nachbereitung datenanalytischer Inhalte.
Deutsche Ausgabe
Von Modellen zu Entscheidungen in Machine Learning mit Python
Vom Modell zur verantwortbaren Entscheidung
Das Buch zeigt, warum Vorhersagen noch keine Entscheidungen und Modelle noch keine Lösungen sind. Es verbindet Machine Learning, Modellbewertung, Unsicherheit, Urteilskraft und Verantwortung mit praktischen Python-Anwendungen.
From Models to Decisions in Machine Learning with Python
From Models to Responsible Decision-Making
The book explains why predictions are not decisions and why models are not complete solutions. It connects Machine Learning, model evaluation, uncertainty, judgment and responsibility with practical Python applications.
Das Buch verbindet Datenanalyse, Argumentation, Statistik, Python und Modellbewertung mit kritischem Denken. Es zeigt, wie aus Beobachtungen, Daten und Modellergebnissen nachvollziehbare und verantwortbare Entscheidungen entstehen.
The book connects data analysis, reasoning, statistics, Python and model evaluation with critical thinking. It explains how observations, data and model results can support transparent and responsible decisions.
Die vollständigen Buchinformationen und Bezugsquellen befinden sich
auf www.mathiasellmann.de.
Nächste Kurstermine
Hinweis: Gesetzliche Feiertage wurden bei der Terminberechnung automatisch berücksichtigt.
Startzeitraum
Kontakt
02
Nov
2026
bis 04.11.2026
3 Schulungstage
inkl. individueller Vertiefung
Mathias Ellmann
Ing., M. Sc.
16
Nov
2026
bis 18.11.2026
3 Schulungstage
inkl. individueller Vertiefung
Mathias Ellmann
Ing., M. Sc.
30
Nov
2026
bis 02.12.2026
3 Schulungstage
inkl. individueller Vertiefung
Mathias Ellmann
Ing., M. Sc.
14
Dec
2026
bis 16.12.2026
3 Schulungstage
inkl. individueller Vertiefung
Mathias Ellmann
Ing., M. Sc.
28
Dec
2026
bis 30.12.2026
3 Schulungstage
inkl. individueller Vertiefung
Mathias Ellmann
Ing., M. Sc.
Kein passender Termin dabei? Gerne prüfen wir individuelle Schulungswünsche.
Mathias Ellmann
Ing., M. Sc.
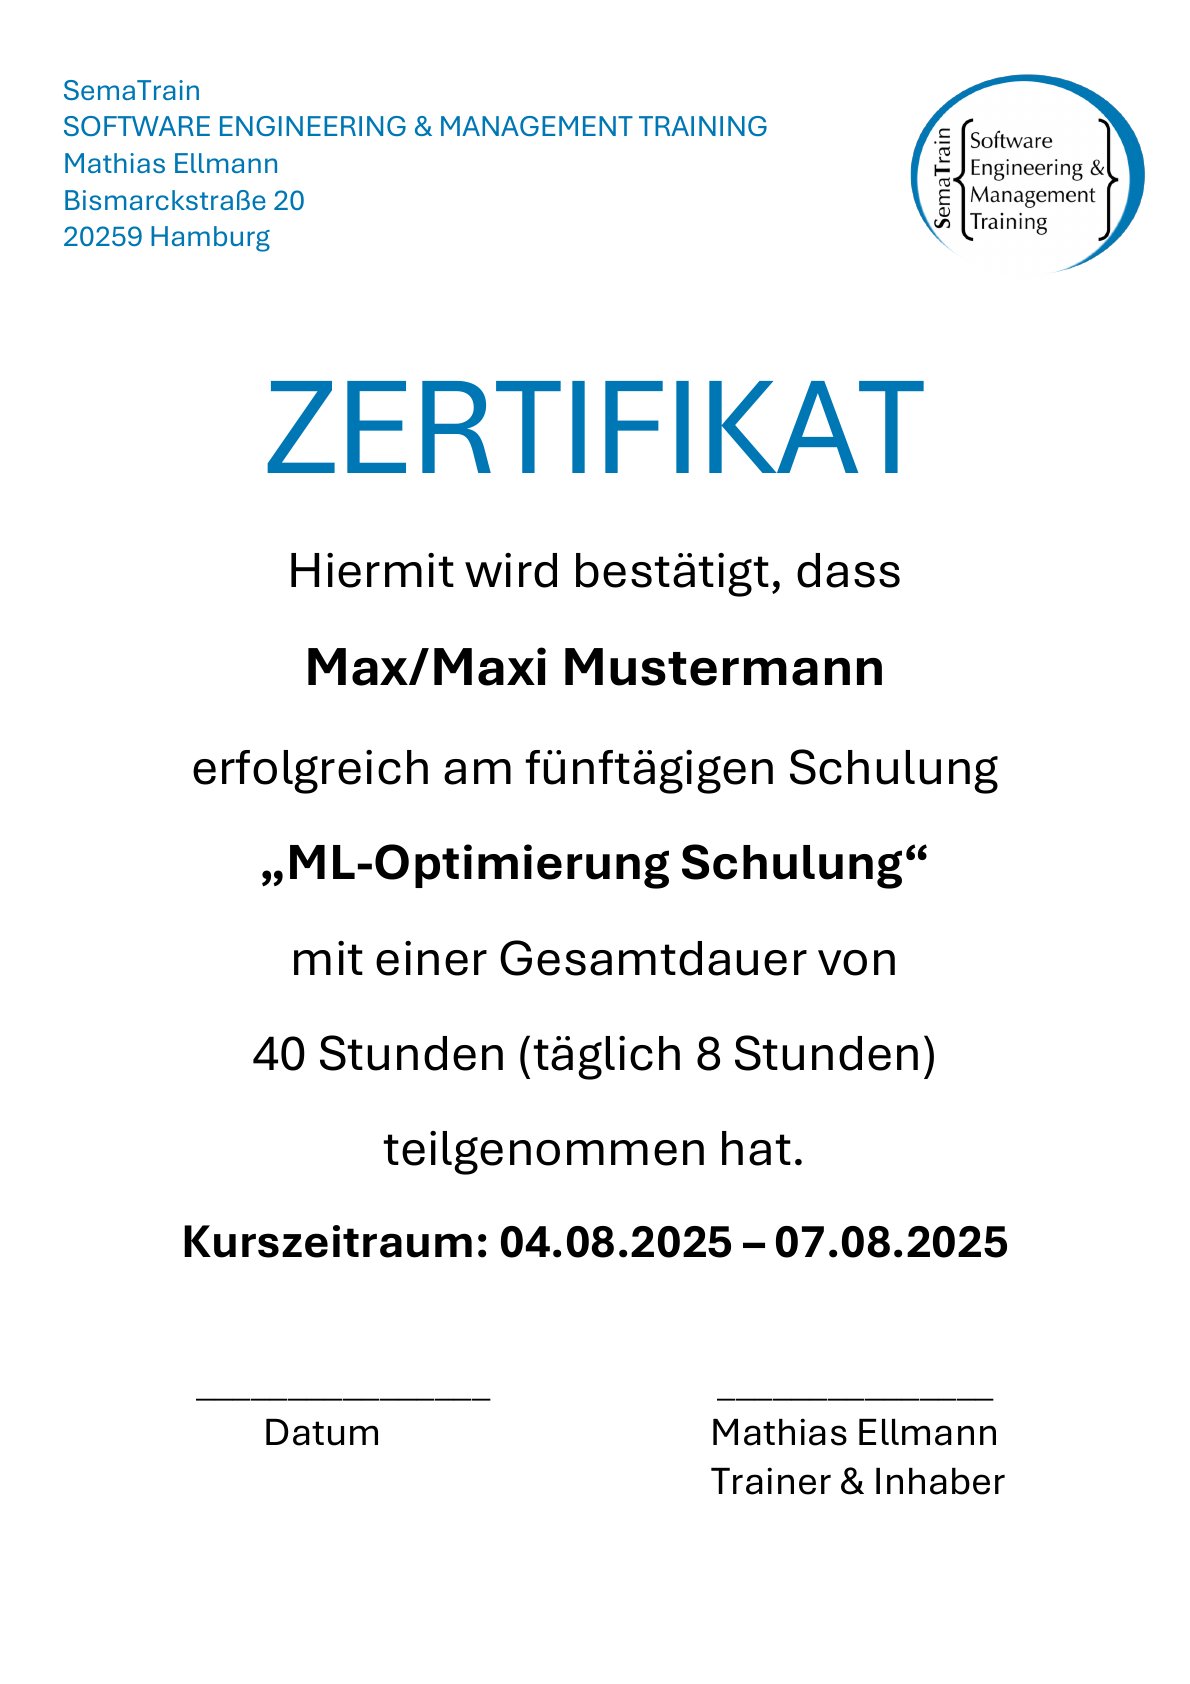
Musterzertifikat
Dies ist die erste Seite des Zertifikats für ML-Optimierung Schulung:
Das vollständige Musterzertifikat kann auf Anfrage per E-Mail bereitgestellt werden.
Häufige Fragen zur ML-Optimierung Schulung
Welche Vorkenntnisse benötige ich für die ML-Optimierung Schulung?
Die ML-Optimierung Schulung richtet sich an Fortgeschrittene mit Erfahrung in Python und scikit-learn. Ein gutes Verständnis für ML-Konzepte und Metriken wie Precision, Recall oder F1 ist erforderlich.
Wie lange dauert die ML-Optimierung Schulung und in welchem Format findet die IT-Schulung statt?
Die ML-Optimierung Schulung umfasst 3 Tage und findet jeweils von 08:30 bis 17:00 Uhr statt – als Online-Schulung oder vor Ort in Hamburg.
Was lerne ich in der ML-Optimierung Schulung konkret?
Sie lernen, wie Sie bestehende ML-Modelle systematisch verbessern – z. B. durch Feature Engineering, Hyperparameter-Tuning mit Optuna oder GridSearchCV sowie Cross-Validation und MLOps-Grundlagen.
Für wen eignet sich die ML-Optimierung Schulung besonders?
Diese IT-Schulung ist ideal für Data Scientists und ML-Engineers, die bestehende Modelle analysieren, optimieren und produktiv einsetzen möchten – auch im Hinblick auf Skalierung und Wartbarkeit.
Erhalte ich ein Zertifikat für die Teilnahme an der ML-Optimierung Schulung?
Ja, Sie erhalten ein offizielles Schulungszertifikat mit allen behandelten Inhalten und der Teilnahmebestätigung für Ihre Unterlagen oder Weiterqualifikation.
Wie unterstützt die ML-Optimierung Schulung meinen Lernerfolg?
Die IT-Schulung basiert auf dem Lehrbaummodell mit Fokus auf Reflexion, Praxisbezug, strukturierter Modellanalyse und kritischer Bewertung automatisierter Optimierungsmethoden.
Wie erfolgt die Bezahlung für die ML-Optimierung Schulung?
Nach Anmeldung erhalten Sie eine Rechnung per E-Mail. Die Zahlung erfolgt per Überweisung vor Kursbeginn. Individuelle Vereinbarungen wie Ratenzahlung sind nach Rücksprache möglich.
Kann ich die ML-Optimierung Schulung stornieren?
Bis 14 Tage vor Beginn ist eine kostenfreie Stornierung möglich. Danach gelten gestaffelte Gebühren. Sie können alternativ kostenfrei auf einen anderen Termin umbuchen.
Ist die ML-Optimierung Schulung auch für Teams geeignet?
Ja, für Gruppen ab drei Personen bieten wir individuelle IT-Angebote – z. B. als Inhouse-Schulung oder speziell auf Ihren ML-Stack zugeschnittene Online-Trainings.
Kann ich für die ML-Optimierung Schulung einen Bildungsgutschein nutzen?
Aktuell ist die ML-Optimierung Schulung nicht über Bildungsgutscheine (z. B. AZAV) förderfähig.